
Orkas が目指しているのは、AI ネイティブな会社を支える土台になることです。この目標からは、避けて通れない問いが 1 つ出てきます。複数の人と複数のエージェントが同じプロジェクトに関わるとき、どう協働すればよいのか、という問いです。
その答えは、私たちが慣れ親しんだチームワークとはかなり違うものになります。理由を説明するには、まず人と人の協働がどこから来たのかを振り返るのが近道です。(製品での具体的な使い方は、「共有プロジェクト:Orkas で人と AI エージェントが協働する仕組み」で順を追って説明しています。この記事では、その背後にある考え方を扱います。)
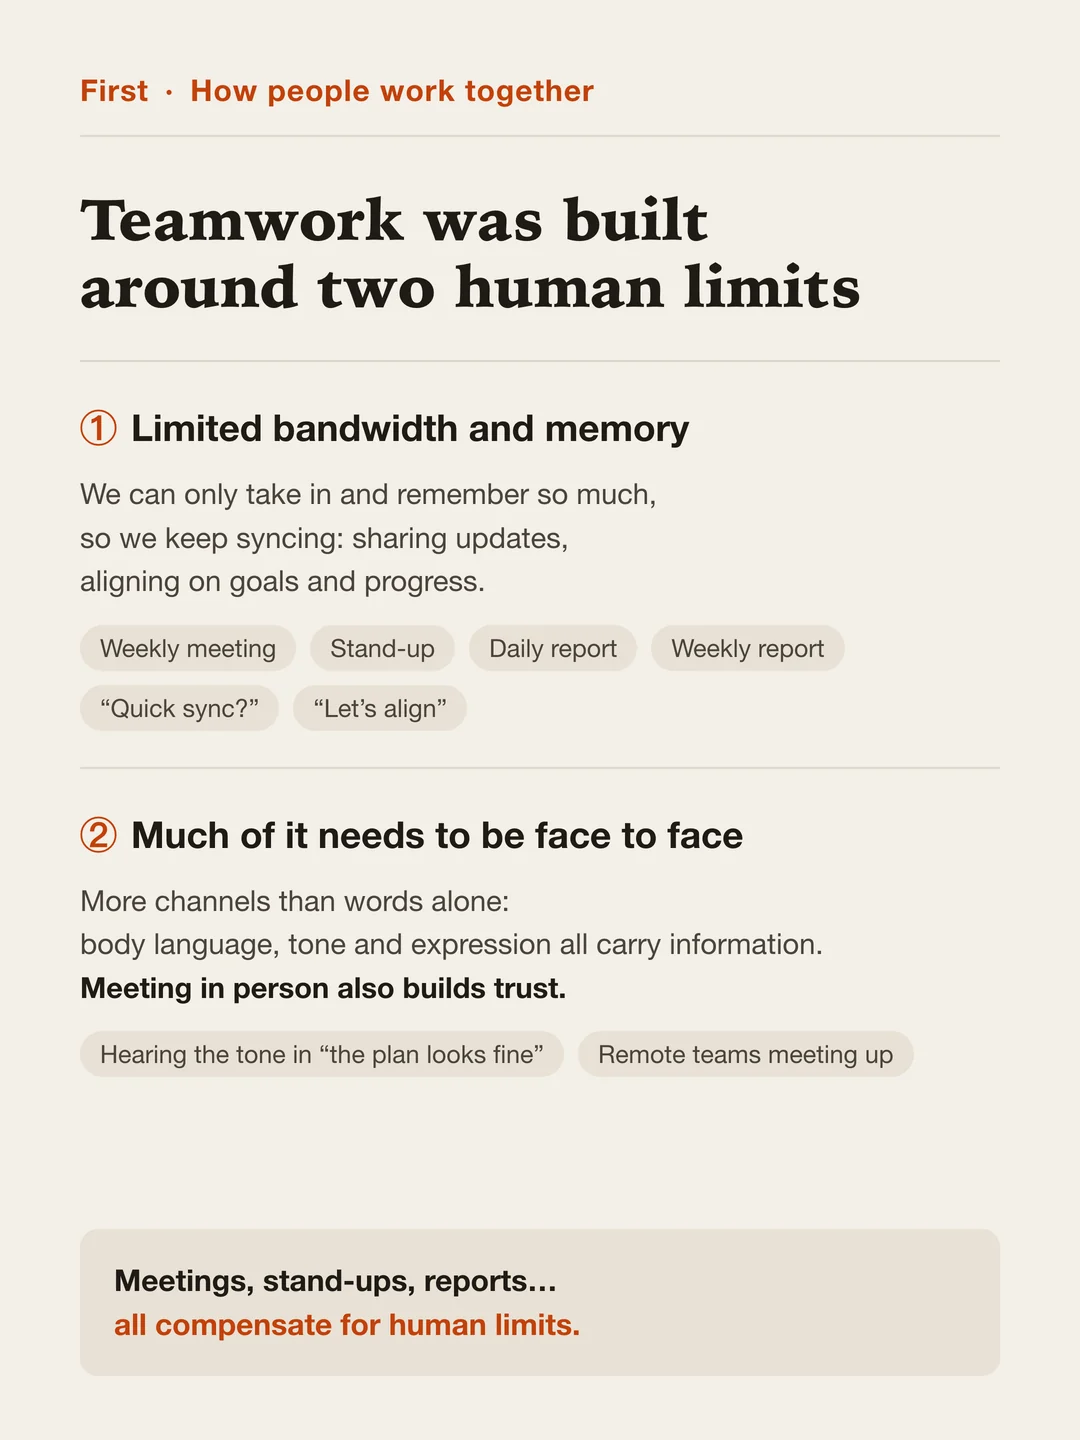
人の協働は、人の 2 つの限界を中心に形づくられてきた
1 つ目は、人が扱える情報の帯域にも記憶にも限りがあることです。一度に受け取れる情報にも、覚えておける量にも限界があります。だからチームは絶えずコミュニケーションを取る必要があります。近況を共有し、目標をそろえ、進捗をそろえる。週次ミーティング、朝会、日報や週報、「ちょっと同期できますか?」「認識を合わせましょう」。どれもこの限界を補うためのものです。
2 つ目は、その多くを対面で行う必要があることです。対面では、言葉以外にも情報の通り道があります。身ぶり、声のトーン、表情のどれもが情報を運びます。テーブルの向こうで誰かが「この案でいいと思います」と言えば、本心かどうかは聞けばわかります。同じくらい大事なのが、直接会うことで信頼が生まれることです。だからこそ、多くのリモートチームが今でも定期的に顔を合わせています。
エージェントが加わると何が変わるか
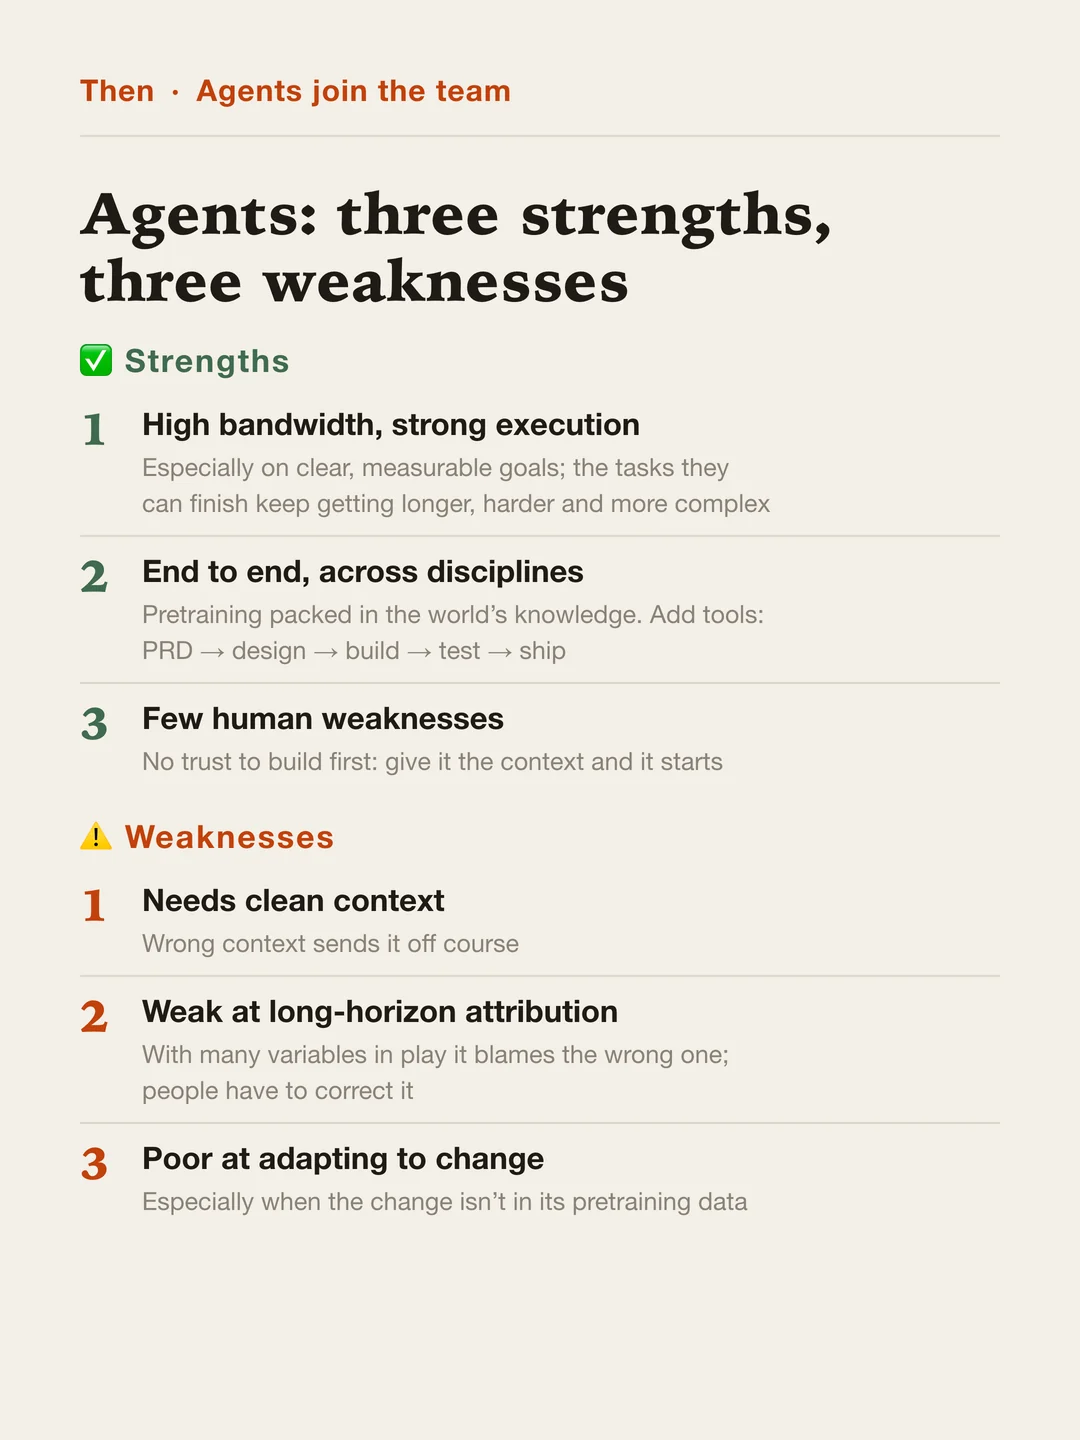
人とエージェントが混在するチームでも、協働の人間的な側面は引き続き大切です。ただ、エージェントとの協働は、人との協働とは大きく違います。エージェントには、はっきりした強みが 3 つと、はっきりした弱みが 3 つあります。
3 つの強み
帯域が広く、実行力が高い。目標が明確で測定できるタスクでは、特にそうです。しかも、エージェントがやり遂げられるタスクは、長さも難しさも複雑さも急速に増しています。Meta は自社のコーディングエージェントを紹介する中で、GPU カーネルの最適化タスクでエージェントが最長 24 時間作業し、1,000 回以上ツールを呼び出した例を挙げています(Meta)。2026 年 10 月には、Linus Torvalds が Linux カーネルのパッチシリーズを投稿しました。コード、テストプログラム、コミットメッセージの初稿は Claude Code が書き、計測は本人が自分のマシンで行っています(LWN)。
世界の知識とツールを備え、分野をまたいで最初から最後までこなせる。世界の知識は、事前学習の段階ですでにモデルに詰め込まれています。適切なツールを渡せば、エージェントは 1 つの仕事を、分野をまたいで最初から最後まで運べます。PRD を書く → デザインする → 作る → テストする → リリースする。同じ仕事を人が担うと、プロダクト、デザイン、エンジニアリング、QA の連携が必要になり、引き継ぎのたびに認識合わせがもう一度発生します。
人間らしい弱点が少なく、先に信頼を築く必要もない。エージェントは疲れませんし、機嫌の悪い日もなく、基本的な質問をためらうこともありません。新しいエージェントは、プロジェクトのコンテキストを受け取ればすぐに仕事を始められます。慣れるまでの期間も、先に築くべき関係もありません。
3 つの弱み
きれいなコンテキストが必要。間違ったコンテキストを与えると、進む方向がずれます。私たち自身もこれを経験しました。分析ダッシュボードのあるフィールドに、データは「紐づけできない」と表示されていました。実際には紐づけできたのに、そのフィールド自体の計算が間違っていたのです。別々の 2 つのエージェントがその一文を読み、どちらもユーザージャーニー分析をまるごと取りやめてしまいました。人がその結論を見れば「これ、今も正しいの?」と確かめるはずです。エージェントはたいてい、そのまま受け取ります。
長いスパンでの原因の切り分けが苦手。複数の変数が同時に結果に影響していると、間違った要因に原因を求めやすく、人が修正しなければなりません。しばらくの間、私たちのサイトのいくつかの新しいページが Google にインデックスされないことがありました。あるエージェントは「サイトの権威性が足りないので、Google がクロールバジェットを割いてくれない」と結論づけ、まず被リンクを増やすよう提案しました。私たちが疑問をぶつけて確認したところ、サイトのページの大半はすでにインデックスされていました。インデックスされていなかった数ページは、どちらかといえば、サイトの本来のテーマから題材が離れすぎているように見えました。クロールバジェットは関係なく、被リンクを増やしていたら見当違いの手を打つところでした。
変化する環境に適応するのが苦手。その変化が事前学習データに含まれていない場合は、特にそうです。リニューアルしたばかりのサイト、変わったばかりのプラットフォームのルール、先月出たばかりの製品。人は「何か違う」と気づいてやり方を変えます。エージェントは手持ちの知識のまま作業を続け、同じことを何度も繰り返し試しがちです。
なぜチャットアプリは合わないのか
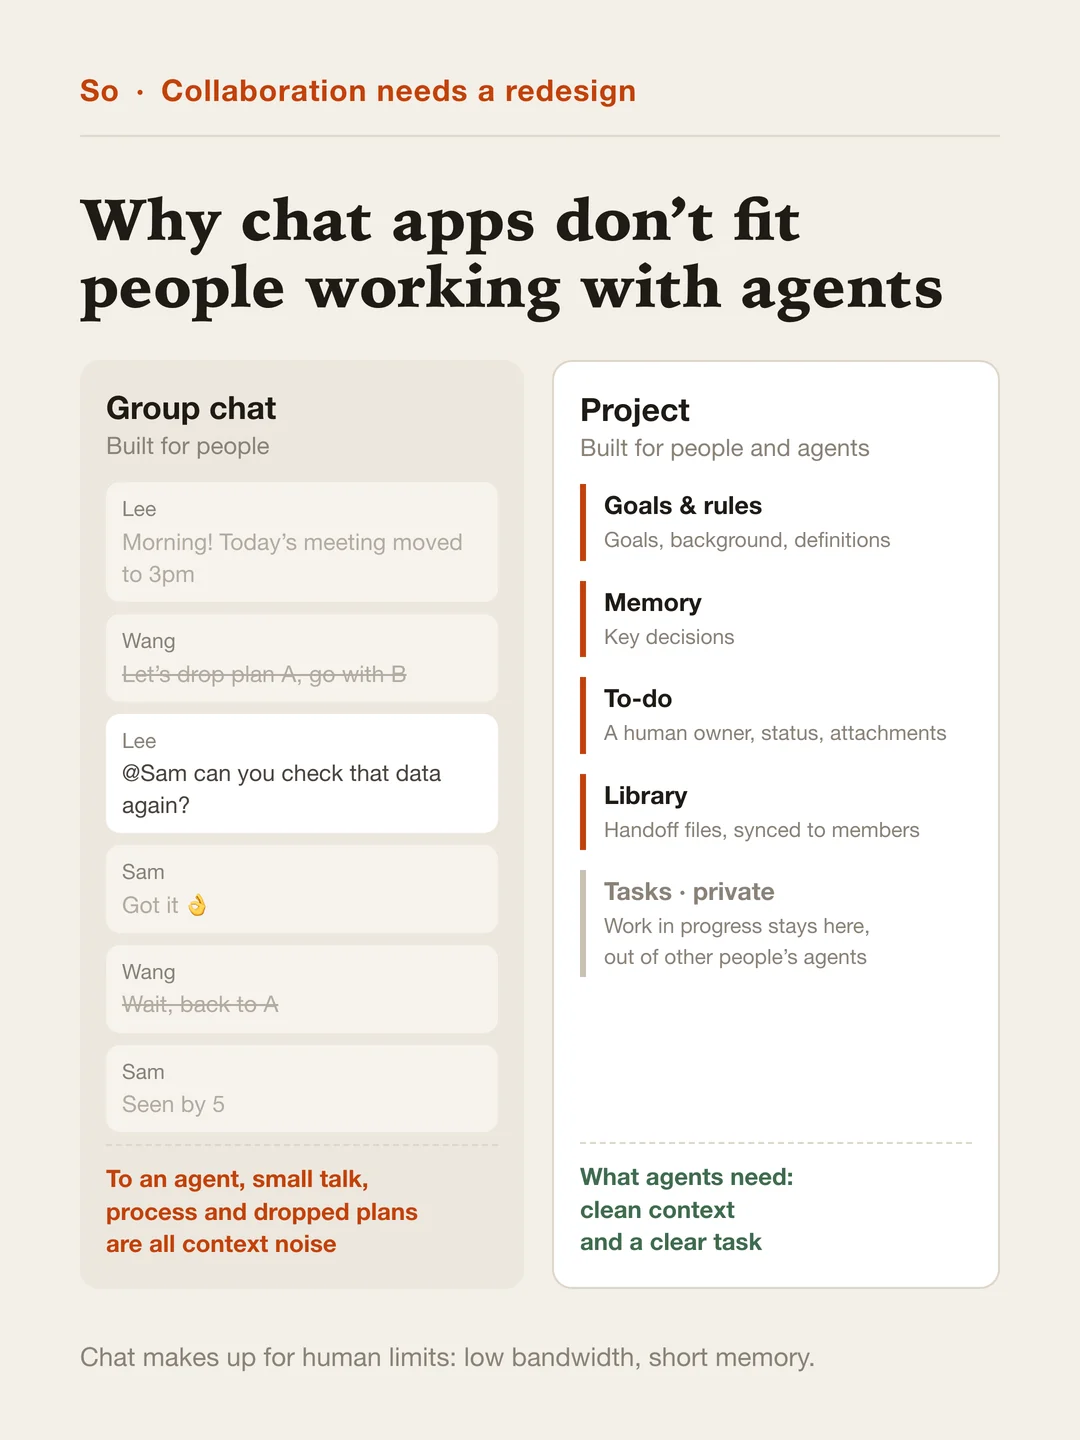
チャットアプリは、人と人が一緒に働くために設計されています。メッセージは次々と流れ、@メンションと既読表示で全員の足並みをそろえ、情報はチャンネルごとに散らばります。この設計は、まさに先ほどの 2 つの限界を補うためのものです。人は帯域が狭く記憶も短いので、投稿し続け、認識を合わせ続けるのです。
エージェントにとっては、この形が合っていません。
- 雑談、途中の議論、後で取り下げられた案は、エージェントにとってはすべてコンテキストのノイズです。
- エージェントは、会話を通じて信頼を築く必要がありません。
- エージェントが本当に必要としているのは、きれいなコンテキストと明確なタスクです。
だから、人とエージェントの協働は設計し直す必要があります。そしてエージェントの能力が上がり続けるにつれて、協働の仕方も変わり続けます。Orkas でも、まだ答えを探っているところです。
Orkas のやり方:変わらないものは残し、変わったものは設計し直す
私たちの方針は、協働のうち変わっていない部分は残し、変わった部分を設計し直すことです。下の画像は Orkas の共有プロジェクトです。4 つの考え方が、強調表示した 4 つの領域にそれぞれ対応しています。
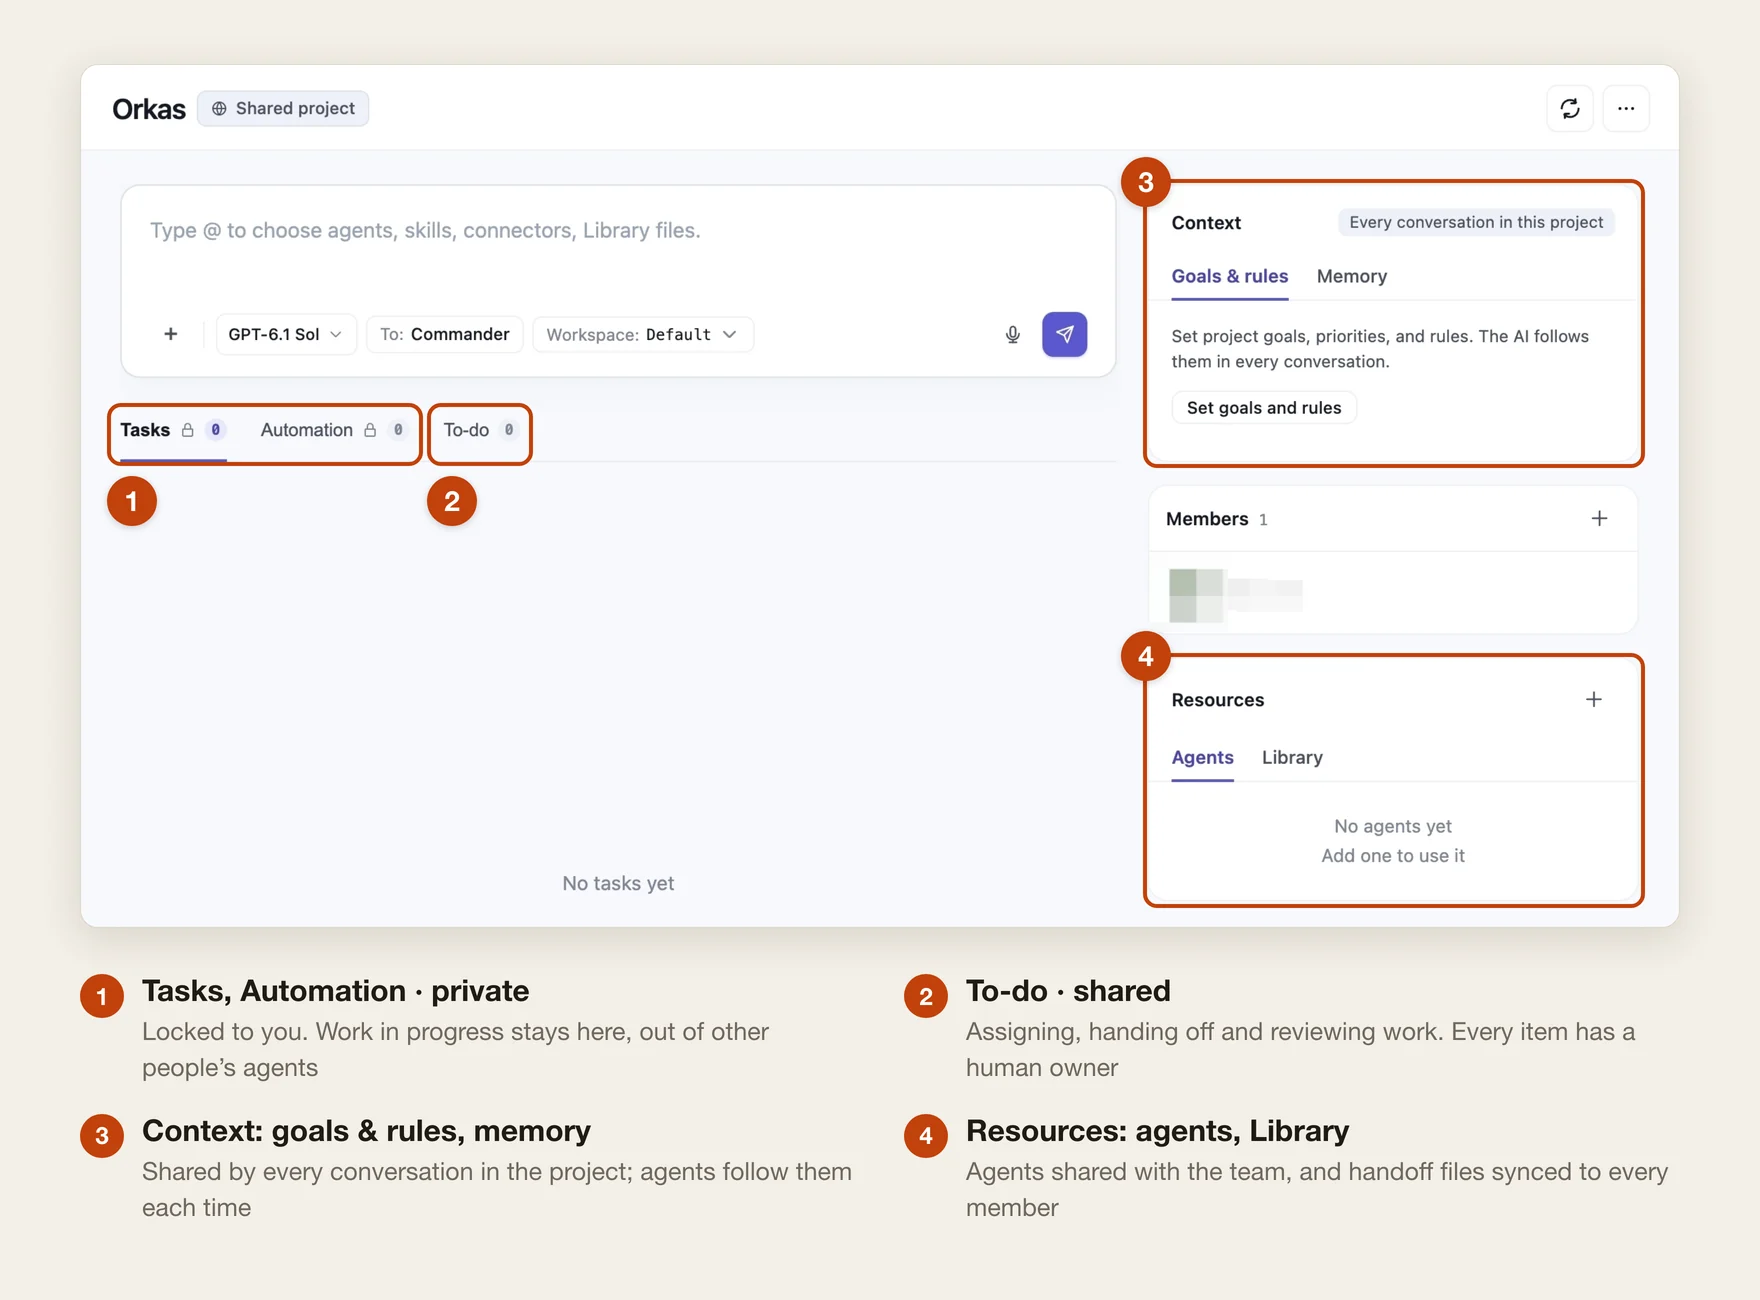
1. 仕事の割り当て、引き継ぎ、レビュー:ToDo
これはエージェントが登場するずっと前からあったもので、今も必要です。今のところ、私たちのプロジェクトではすべてのタスクに人間の担当者がいて、最終的な結果には人が責任を持ちます。
製品では、次のように動きます。各 ToDo は 1 人の人に割り当てられ、どのエージェントに作業させるかはその人が決めます。ToDo を開始できるのは担当者だけです。エージェントは担当者自身のコンピューター上で、担当者のモデルとクレジットを使って動きます。作業が終わると、エージェントは自分で完了にするのではなく、ToDo を確認待ちに移します。担当者が確認し、必要な修正を加えたところで、はじめて完了になります。
2. 目標、背景、コンテキストの共有:目標とルール、メモリ
ここでは人とエージェントが同じコンテキストを共有するので、重要な事実の認識がずれません。
プロジェクトの目標とルールとメモリは、このプロジェクトの全会話で共有され、エージェントは毎回それに従います。たとえば「月次リテンション=翌月にまた戻ってきた新規ユーザー」のような指標の定義を目標とルールに書き、重要な決定はプロジェクトメモリに記録しておきます。新しいメンバーとそのエージェントが加わると、初日からまったく同じ内容を読むことになります。
3. ファイルで引き継ぎ、過程は切り離す
プロジェクトのライブラリはメンバー間で同期され、ToDo には任意のファイルを添付できます。仕事はチャット履歴ではなく、ファイルで引き継がれます。
途中の過程の大部分は、あえて切り離しています。エージェントにとって有害なコンテキストのノイズにならないようにするためです。ロックされたタスクと自動化のタブは、あなただけのものです。エージェントは 1 本のレポートを仕上げるまでに、数百ステップを踏み、3 つのアプローチを試すかもしれません。同僚が受け取るのはレポートだけです。過程はあなた自身のタスクに残り、同僚のエージェントのコンテキストに入り込むことはありません。
4. 個人用のエージェントをチームと共有する
メンバーは、自分の個人用エージェントをチームのほかのメンバーが使えるように共有できます。こうしたエージェントには、持ち主の経験と品質を見極める目が込められています。共有すれば全員の仕事が速くなり、使う中で見つかった問題は自己進化で直していけるので、プロジェクト全体でできることが広がります。
エージェントを共有すると、Orkas はその作業指示とスキルをまとめてパッケージにします。作業の中でエージェントが自分で身につけたスキルも含まれます。メモリとチャット履歴は含まれません。共有した人がエージェントを更新すると、メンバーには新しいバージョンが自動で届きます。
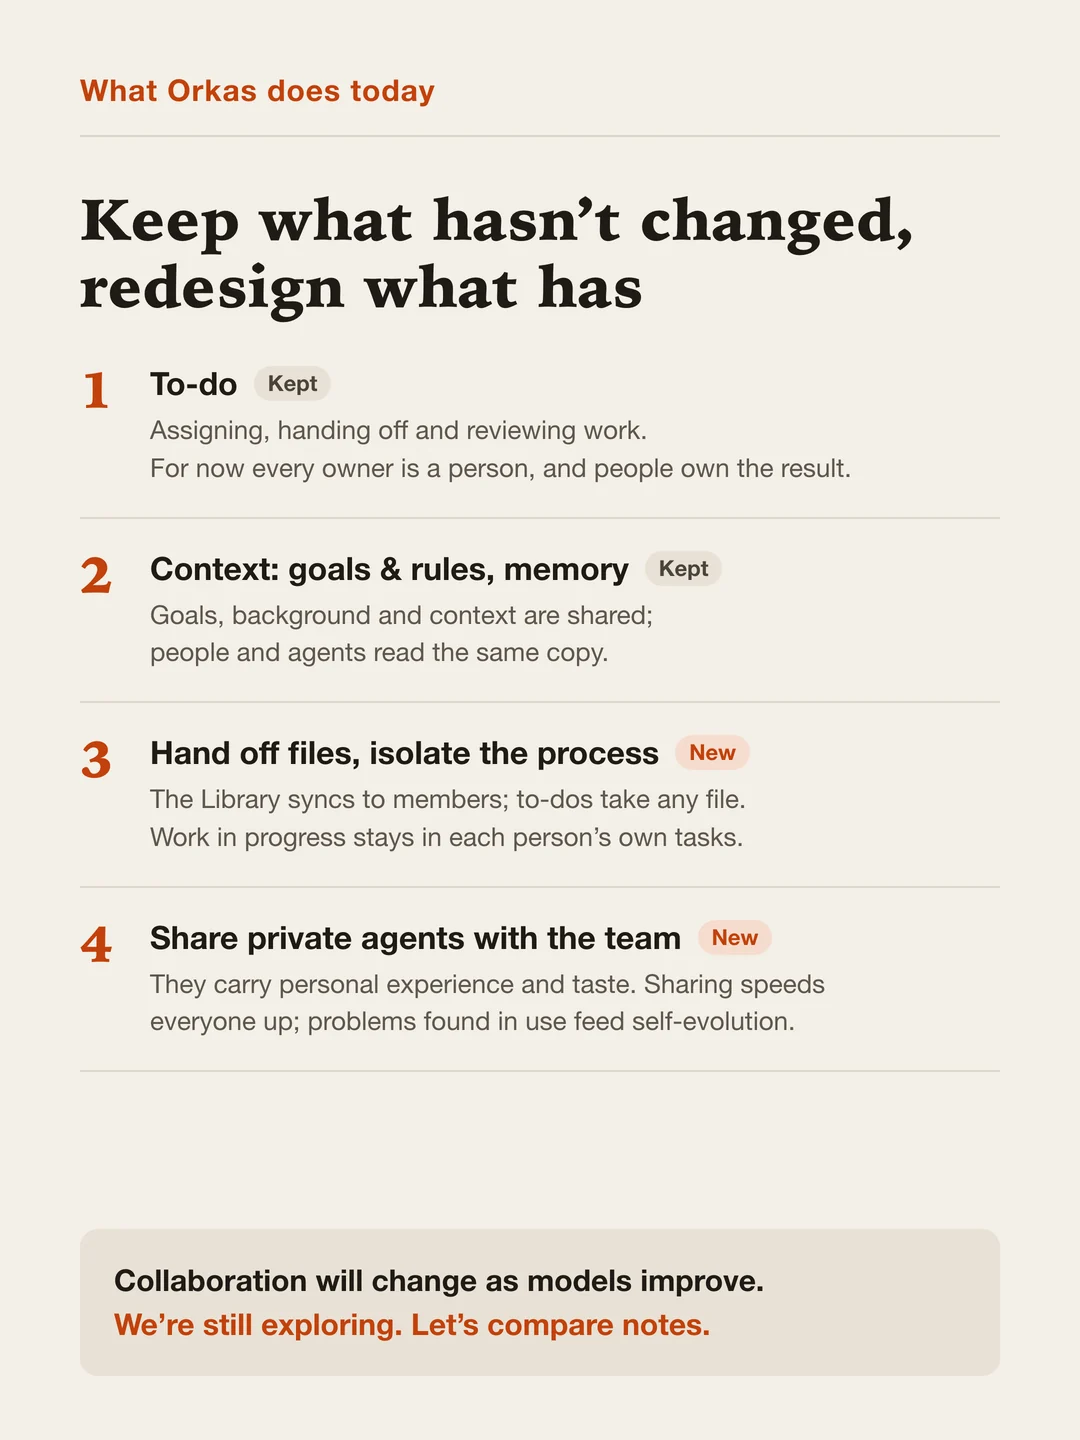
始まったばかりの、答えの出ていない問題
人とエージェントの協働はまだごく初期の段階にあり、答えは収束していません。モデルが進化するにつれて、エージェントが協働に必要とするものの多くは、モデルそのものに移っていきます。
すでにこれをネイティブにこなせるモデルもあります。複数のサブエージェントを並行して動かし、問題をさまざまな角度から探る。あるいは、まず計画を立ててから、サブエージェントに実行を割り振る。Meta が 2026 年 10 月にオープンウェイトで公開した Muse Spark Open は、作業を分解してサブエージェントに渡し、それらを調整するように訓練されていると説明されています(PyTorch ブログ)。
つまり、協働の仕方はモデルの進化とともに変わっていきます。ToDo、共有コンテキスト、ファイルでの引き継ぎ、共有エージェントは、今のモデルにできることに対する私たちの答えであり、最終形ではありません。
おわりに
変わらないものは残しました。誰かが仕事を受け持ち、誰かがレビューし、目標とコンテキストの認識をそろえ続けることです。変わったものは設計し直しました。ファイルで引き継ぎ、過程は切り離し、一人ひとりの経験とセンスをチームが使えるエージェントに変えることです。
私たちもまだ模索している途中で、ぜひ意見を交換したいと考えています。人とエージェントが一緒に働くチームを率いているなら、まずは 1 つのプロジェクトで試してみてください。Orkas は macOS と Windows 向けに無料でダウンロードできます。